RAG-система: как нейросеть отвечает по документам компании
Что такое RAG-система простыми словами: как ИИ находит ответы в документах компании и показывает источники, из чего она состоит, почему ошибается, чем отличается от дообучения модели и как внедрить её в российском контуре.
Ключевые тезисы:
- ✓ RAG — генерация ответа с поиском по документам: нейросеть сначала находит нужные фрагменты, потом отвечает только по ним
- ✓ Модель не нужно переобучать: документы обновляются каждый день
- ✓ Ответ приходит со ссылкой на документ и раздел — его можно проверить
- ✓ Качество больше зависит от подготовки документов и поиска, чем от выбора нейросети
- ✓ Систему можно развернуть в российском контуре на GigaChat MAX, YandexGPT или открытой модели
RAG-система: как нейросеть отвечает по документам компании
Сотрудник спрашивает: «Какой срок поставки у нас прописан в договоре с этим поставщиком?» или «Как оформить возврат по новому регламенту?». Обычная нейросеть на такие вопросы не ответит: она не видела ваших договоров и регламентов, а если и ответит — уверенно выдумает. Чтобы ИИ отвечал по документам компании и показывал, откуда взял ответ, строят RAG-систему.
Разбираем простыми словами, как она устроена, где приносит пользу, почему иногда ошибается и как внедрить её так, чтобы данные не ушли за пределы компании.
Коротко
- RAG (генерация ответа с поиском по документам) — подход, при котором нейросеть сначала находит нужные фрагменты в базе знаний компании, а потом формулирует ответ только по ним.
- Модель не нужно переобучать: документы можно добавлять и обновлять каждый день, ответ всегда опирается на актуальную версию.
- Главное преимущество — ответ со ссылкой на источник: сотрудник видит, из какого документа и пункта взята информация, и может проверить.
- Качество RAG-системы больше зависит от подготовки документов и поиска, чем от выбора нейросети.
- Систему можно развернуть полностью в российском контуре: GigaChat MAX или YandexGPT в защищённом облаке либо открытая модель на своих серверах.
Что такое RAG-система простыми словами
Название RAG происходит от английского Retrieval-Augmented Generation — генерация ответа, дополненная поиском. Подход описали исследователи в 2020 году, а сегодня он стал стандартом для корпоративных ИИ-помощников.
Представьте нового сотрудника, которому дали доступ к архиву компании. На каждый вопрос он сначала идёт в архив, находит два-три подходящих документа, читает нужные абзацы и только потом отвечает — с пометкой «см. договор №15, пункт 4.2». RAG-система работает так же, только ищет за доли секунды и по тысячам документов сразу.
Важно понимать, чем RAG отличается от обычного чат-бота с нейросетью:
| Нейросеть без RAG | RAG-система | |
|---|---|---|
| Откуда знания | Только то, на чём модель обучалась | Документы компании + общие знания модели |
| Актуальность | Застыла на дате обучения | Обновляется вместе с документами |
| Ссылки на источник | Нет | Есть: документ, раздел, страница |
| Выдуманные ответы | Часто, особенно по внутренним темам | Редко: модели запрещено отвечать без найденного фрагмента |
| Доступ к закрытым данным | Нет | Да, с учётом прав пользователя |
Как устроена RAG-система: пять шагов
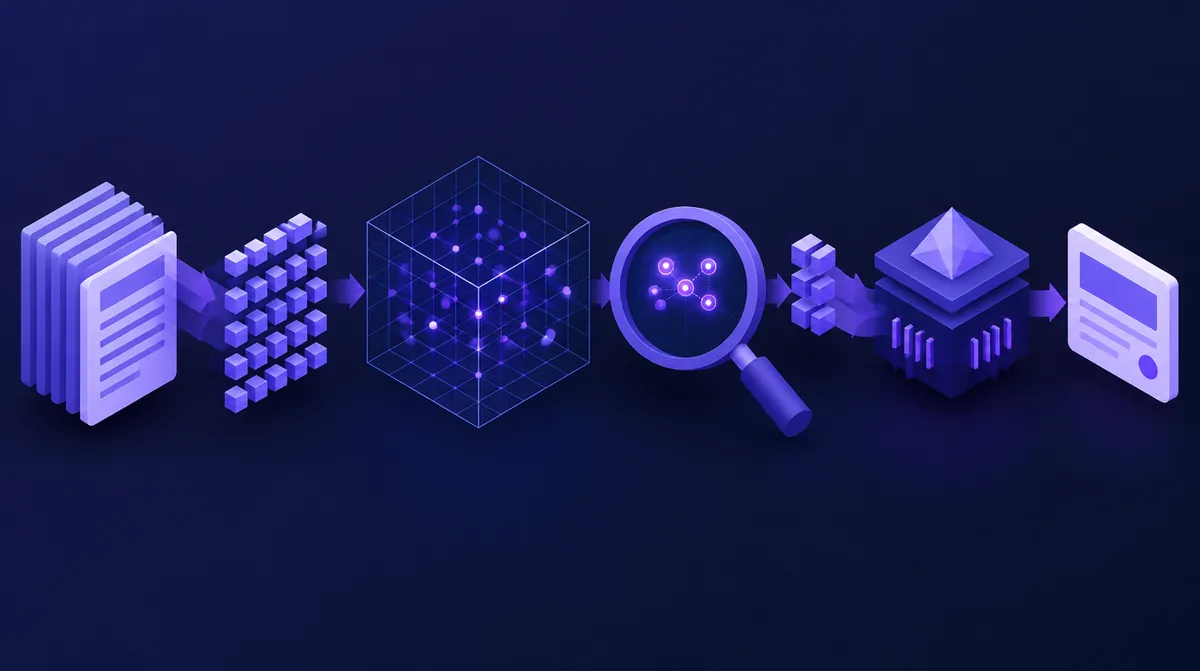
1. Сбор документов. Система подключается к источникам знаний: папкам с договорами и регламентами, базе знаний в Битрикс24 или Confluence, справочникам 1С, почте службы поддержки, сайту. Сканы распознаются, таблицы аккуратно переводятся в текст, дубли и устаревшие версии отсеиваются.
2. Нарезка на фрагменты. Длинный документ делится на смысловые куски — обычно по разделам и абзацам. Если нарезать неудачно, например разорвать таблицу или отделить условие от исключения, система будет находить половину ответа. Поэтому у каждого типа документов свои правила нарезки.
3. Индексация. Каждый фрагмент превращается в векторное представление — набор чисел, который описывает смысл текста. Похожие по смыслу фрагменты получают близкие векторы, даже если написаны разными словами: «срок оплаты» и «когда нужно перечислить деньги» окажутся рядом. Векторы хранятся в специальной базе данных — например, PostgreSQL с расширением pgvector, Qdrant или OpenSearch.
4. Поиск. Когда сотрудник задаёт вопрос, система ищет самые близкие по смыслу фрагменты и дополняет их обычным поиском по словам — так не теряются точные совпадения вроде номеров договоров и артикулов. Затем отдельная модель переранжирования выбирает из найденного 3–10 самых полезных фрагментов.
5. Ответ. Найденные фрагменты вместе с вопросом передаются большой языковой модели — GigaChat MAX, YandexGPT, GPT, Claude или открытой модели. Модель получает инструкцию: отвечать только по этим фрагментам, указывать источники, а если ответа в документах нет — честно сказать «не нашёл». Сотрудник получает ответ и ссылки на документы.
Где RAG-система приносит пользу бизнесу
Поддержка клиентов. ИИ-бот отвечает на вопросы по условиям доставки, гарантии, тарифам и инструкциям. Ответы берутся из актуальной базы знаний, а сложные обращения передаются оператору вместе с найденными документами. Подробнее — в нашем разделе про ИИ-ботов для бизнеса.
База знаний для сотрудников. Вместо поиска по десяткам папок — один вопрос в чате: «Как согласовать командировку?», «Какие документы нужны для приёма иностранца?». Особенно полезно для новичков и филиалов.
Юристы и договорной отдел. Поиск условий по массиву договоров: у каких поставщиков есть штраф за просрочку, где не согласован порядок расторжения, чем отличается новая редакция от старой.
Продажи и техническая поддержка. Менеджер быстро находит характеристики продукта, совместимость, ответы на типовые возражения, а инженер — нужный раздел технической документации на оборудование.
Работа с данными 1С. RAG-систему можно связать с 1С: сотрудник спрашивает про остатки, статусы заказов или условия договора, а ИИ отвечает по данным учётной системы и регламентам. Как это устроено — на странице внедрения ИИ в 1С.
ИИ-агенты. RAG — это «память» ИИ-агента. Агент, который разбирает входящие заказы или готовит коммерческие предложения, обращается к базе знаний за прайсами, условиями и шаблонами. Подробнее — в разделе разработка ИИ-агентов.
Почему RAG-система ошибается и как это исправить
Самая частая жалоба после первого запуска — «бот отвечает невпопад». Почти всегда виновата не нейросеть, а одна из этих причин:
- Плохой поиск. Система находит не те фрагменты — и модель честно пересказывает не то. Лечится правильной нарезкой, гибридным поиском (по смыслу и по словам) и переранжированием.
- Грязные документы. Три версии одного регламента, отсканированные таблицы, которые распознались кашей, устаревшие прайсы. Нейросеть не знает, какой документ главный, если ей этого не сказать. Нужны очистка, метки актуальности и ответственный за базу знаний.
- Вопросы, на которые нет ответа в документах. Если модель не ограничить, она дополнит ответ собственными знаниями и может ошибиться. Инструкция «отвечай только по найденным фрагментам» и проверка ответа на опору на источники снижают риск выдуманных ответов.
- Таблицы и цифры. Вопросы вида «сколько всего» и «сравни за три года» плохо решаются поиском по тексту. Для них RAG-систему дополняют запросами к базе данных или 1С.
- Нет оценки качества. Без набора контрольных вопросов с правильными ответами невозможно понять, стало лучше или хуже после изменений. Мы собираем 50–200 реальных вопросов сотрудников и прогоняем их после каждой доработки.
RAG или дообучение модели
Частый вопрос: не проще ли «дообучить нейросеть на наших документах»? Для большинства задач — нет.
| RAG-система | Дообучение модели | |
|---|---|---|
| Новые документы | Добавляются за минуты | Нужно повторное обучение |
| Ссылки на источник | Есть | Нет |
| Права доступа | Учитываются при поиске | Невозможно разграничить |
| Стоимость старта | Ниже | Выше: данные, вычисления, эксперименты |
| Когда подходит | Ответы по фактам из документов | Особый стиль, формат или узкая терминология |
На практике дообучение иногда добавляют поверх RAG — например, чтобы модель писала в стиле компании. Но знания о фактах надёжнее хранить в документах, а не «зашивать» в модель.
Безопасность: RAG-система в российском контуре
В базу знаний попадают договоры, данные клиентов, внутренние регламенты — то, что нельзя отправлять в зарубежные сервисы. С 1 июля 2025 года запись и хранение персональных данных граждан РФ в базах за рубежом запрещены, а штрафы за утечки выросли до оборотных.
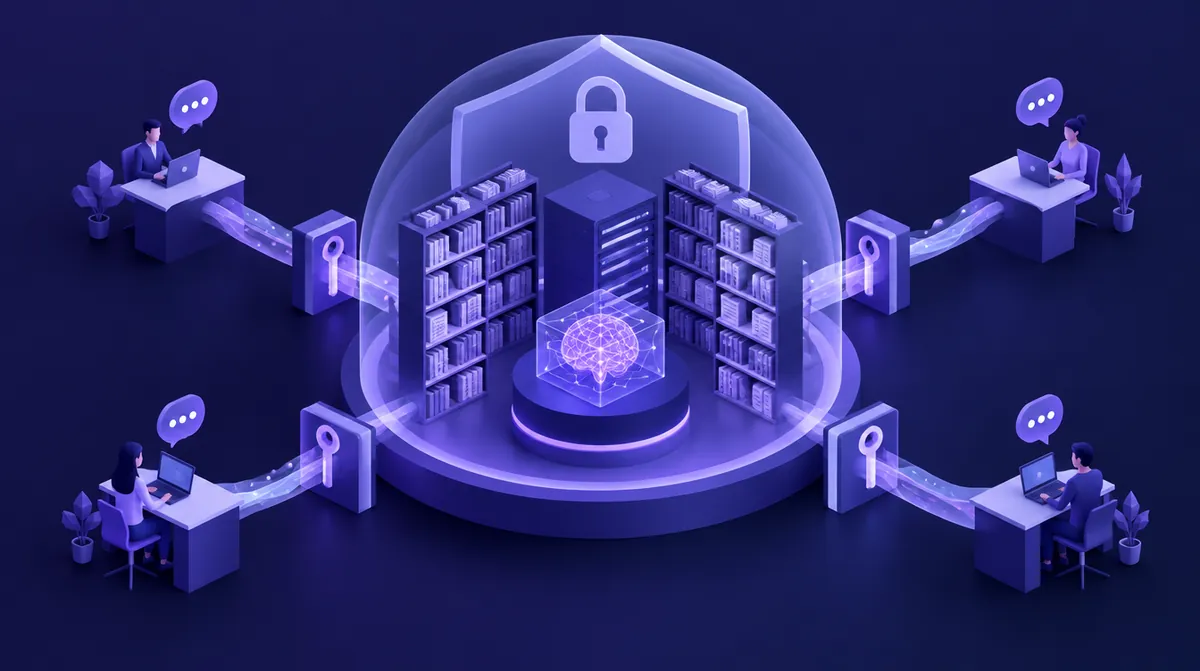
Безопасная RAG-система строится по трём правилам:
- Данные и модель — в России. Российская модель (GigaChat MAX, YandexGPT) в защищённом облаке с сегментом для персональных данных либо открытая модель на серверах компании. Векторная база тоже хранится в контуре компании.
- Права доступа при поиске. Сотрудник отдела продаж не должен получить в ответе фрагмент из кадровых документов. Права из файлового хранилища или Битрикс24 переносятся в индекс, и поиск идёт только по тому, что пользователю разрешено.
- Журнал запросов. Кто, что и когда спрашивал и какие документы получил в ответ — это нужно и для разбора ошибок, и для службы безопасности.
Подробно про требования 152-ФЗ и три архитектуры корпоративного ИИ мы написали в статье «Корпоративный ИИ в закрытом контуре».
Как внедрить RAG-систему: план проекта
- Выбрать одну задачу. Не «ИИ на все документы», а конкретный сценарий: ответы поддержки по базе знаний, поиск по договорам, помощник для новых сотрудников. Определить, кто пользователи и как измерить пользу.
- Собрать контрольные вопросы. 50–200 реальных вопросов с правильными ответами — основа для оценки качества.
- Подготовить документы. Найти источники, убрать дубли и устаревшие версии, настроить распознавание сканов и таблиц.
- Собрать прототип. Нарезка, индексация, поиск, ответы с источниками. Для быстрой проверки идеи удобно собрать цепочку в n8n, для промышленного решения — отдельный сервис.
- Проверить на контрольных вопросах и пилотной группе. Доработать нарезку, поиск и инструкции модели по результатам.
- Подключить к рабочим каналам. Корпоративный мессенджер, Битрикс24, сайт, 1С. Настроить права доступа, журнал и регулярное обновление индекса.
Первый рабочий прототип на реальных документах обычно получается за 2–4 недели, старт проекта — через 3–5 дней после согласования задачи.
Итог
RAG-система — самый практичный способ научить нейросеть отвечать по знаниям компании: без переобучения моделей, со ссылками на источники и с учётом прав доступа. Успех определяет не выбор модели, а качество документов, поиска и проверки. А при работе с персональными данными и коммерческой тайной систему стоит сразу строить в российском контуре.
Хотите проверить, как ИИ справится с вашими документами? Опишите задачу — предложим архитектуру и соберём прототип на ваших данных.
Вопросы и ответы
Что такое RAG-система простыми словами?
RAG-система — это ИИ-помощник, который отвечает на вопросы по документам компании. Сначала он ищет в базе знаний подходящие фрагменты договоров, регламентов или инструкций, а затем нейросеть формулирует ответ только по найденному и указывает источники. Название происходит от английского Retrieval-Augmented Generation — генерация ответа, дополненная поиском. Такой подход позволяет использовать нейросеть для внутренних задач компании без переобучения модели.
Чем RAG-система отличается от обычного чат-бота с нейросетью?
Обычная нейросеть знает только то, на чём её обучили, и ничего не знает о ваших договорах, регламентах и продуктах. На вопросы о внутренних делах компании она либо не ответит, либо уверенно выдумает ответ. RAG-система перед ответом ищет информацию в документах компании и показывает, откуда её взяла. Кроме того, она учитывает права доступа: сотрудник получает ответы только по тем документам, которые ему разрешено видеть.
Что лучше: RAG или дообучение нейросети на своих данных?
Для ответов по фактам из документов почти всегда лучше RAG. Новые документы добавляются за минуты, ответы содержат ссылки на источник, а права доступа учитываются при поиске. Дообучение дороже, требует повторения при каждом обновлении знаний и не позволяет показать, откуда взят ответ. Его имеет смысл добавлять поверх RAG, когда нужен особый стиль, формат ответа или очень узкая терминология.
Можно ли сделать RAG-систему без передачи данных за границу?
Да, и для документов с персональными данными и коммерческой тайной так и нужно делать. Используется российская модель — GigaChat MAX или YandexGPT — в защищённом облаке с сегментом для персональных данных, либо открытая модель на серверах компании. Векторная база данных и журнал запросов тоже хранятся в контуре компании. Так система соответствует требованиям 152-ФЗ о локализации персональных данных.
Сколько времени занимает внедрение RAG-системы?
Первый рабочий прототип на реальных документах обычно собирается за 2–4 недели, а старт проекта возможен через 3–5 дней после согласования задачи. Больше всего времени уходит не на программирование, а на подготовку документов: поиск источников, очистку от дублей и устаревших версий, распознавание сканов и таблиц. Затем систему проверяют на контрольном наборе реальных вопросов и пилотной группе пользователей. Стоимость зависит от объёма и качества документов, числа источников и требований к безопасности — её мы рассчитываем после короткого брифа.